


Table des matières
Dans l’univers complexe de l’intelligence artificielle, le terme « token » revient fréquemment. Essentiel au fonctionnement de nombreux modèles d’IA, ce concept pourrait bien être la clé pour comprendre comment ces systèmes analysent et génèrent du contenu. Plongeons dans l’univers de ces unités essentielles pour découvrir leur rôle dans l’efficacité des intelligences artificielles.
L’essentiel à retenir
Imaginez que vous êtes un chef d’orchestre, mais au lieu de musiciens, vous dirigez des milliers de fragments de texte. Chaque fragment doit être parfaitement synchronisé pour créer une symphonie cohérente. C’est ainsi que fonctionnent les modèles d’intelligence artificielle générative, où chaque « token » joue un rôle crucial dans l’harmonisation des données pour produire des réponses pertinentes et fluides. Découvrons ensemble pourquoi ces unités sont si indispensables dans le paysage actuel de l’IA.
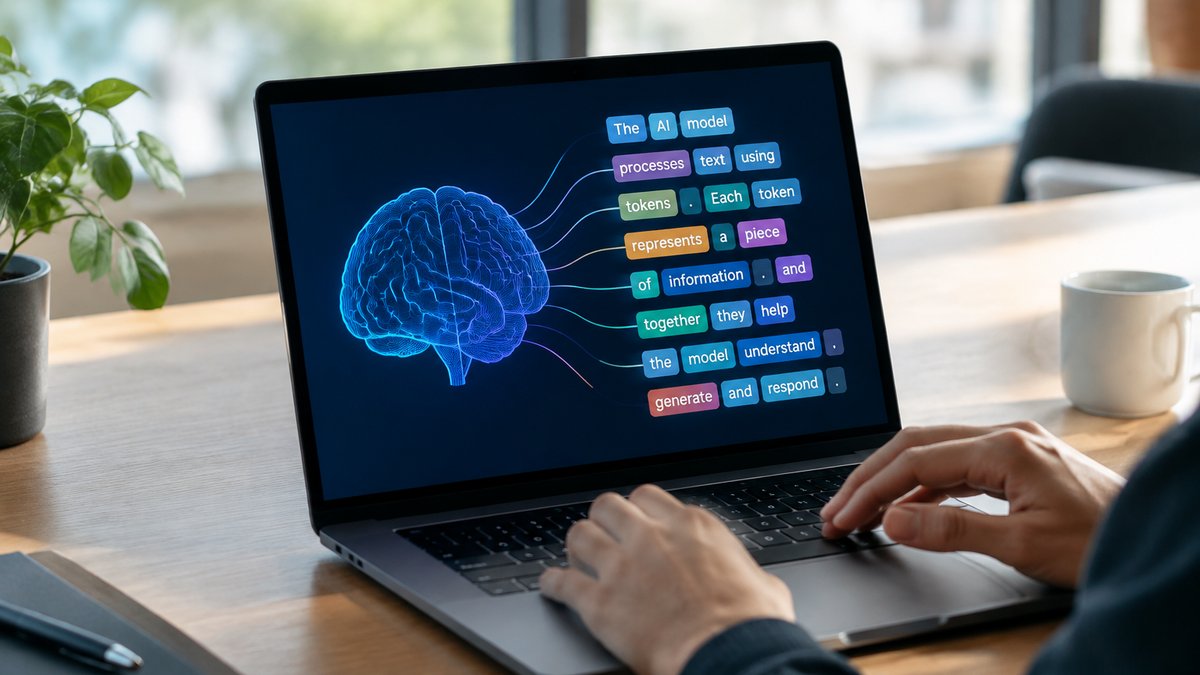
Dans le contexte des modèles de langage, un token est une unité qui découpe les données pour les rendre traitables par le système. Ces unités peuvent inclure des mots entiers, des morceaux de mots, ou même des signes de ponctuation. Le choix de la segmentation dépend du tokenizer, un outil spécifique à chaque modèle d’IA. Par exemple, OpenAI et Google utilisent des tokenizers qui découpent le texte en unités d’environ quatre caractères, soit environ trois quarts d’un mot anglais.
Les tokens jouent un rôle fondamental dans la capacité des modèles à traiter de grandes quantités d’informations. La « fenêtre de contexte » désigne la capacité maximale d’un modèle à manipuler des tokens simultanément, souvent exprimée en centaines de milliers. Cette capacité influence directement la complexité des tâches qu’un modèle peut accomplir, comme analyser des documents volumineux ou maintenir la cohérence d’une longue conversation.
Le processus de tokenisation s’appuie sur un vocabulaire prédéterminé, qui privilégie les séquences de caractères fréquemment rencontrées. Cette approche permet de limiter l’expansion du vocabulaire tout en assurant une efficacité optimale. Lorsqu’un modèle rencontre une séquence de caractères courante, il peut la traiter comme une unité unique, simplifiant ainsi le processus de génération de texte.
Cependant, la tokenisation n’est pas une science exacte. Les modèles doivent parfois jongler avec des séquences rares, nécessitant plusieurs tokens pour les représenter. Ce compromis est essentiel pour maintenir un équilibre entre la précision du traitement et l’efficacité opérationnelle du modèle.
Dans les applications commerciales, notamment via les API, les tokens sont à la base du modèle de facturation. Les tokens de sortie, générés lors de la réponse du modèle, ont généralement un coût plus élevé que les tokens d’entrée, qui sont traités en parallèle. Cette tarification reflète la complexité du traitement requis pour générer des réponses précises et pertinentes.
Pour les utilisateurs, cela signifie que chaque interaction avec le modèle, qu’elle soit simple ou complexe, a un coût associé. Cette approche permet de gérer efficacement les ressources tout en offrant des services d’IA avancés aux entreprises et aux développeurs.
Les modèles multimodaux, capables de traiter des images, de l’audio et des vidéos, s’appuient également sur le concept de tokenisation. Toutefois, le processus est plus complexe que pour le texte. Par exemple, la résolution d’une image ou la durée d’un enregistrement audio influencent le nombre de tokens nécessaires pour le traitement. Cette complexité supplémentaire nécessite des approches de tokenisation adaptées pour chaque type de contenu.
Avec l’essor des modèles multilingues et multimodaux, les tokens prennent une nouvelle dimension. Ils ne se contentent plus de segmenter le texte, mais deviennent des ponts entre les langues et les formats de données. L’avenir pourrait voir l’émergence de systèmes encore plus intégrés, où la tokenisation s’adapte dynamiquement au contenu pour optimiser la compréhension et la génération d’informations.
Les chercheurs explorent également la possibilité de réduire la dépendance aux tokens en développant des systèmes capables de comprendre des idées et des concepts plus abstraits. Cette évolution pourrait transformer la manière dont nous interagissons avec l’IA, en abaissant les barrières linguistiques et en facilitant une communication plus naturelle.
Le secteur de l’IA générative doit relever des défis de scalabilité, notamment en matière de coûts et d’efficacité énergétique. L’entraînement de modèles volumineux, tels que ceux développés par Anthropic ou DeepMind, nécessite d’énormes ressources informatiques. Ces exigences soulèvent des questions sur la durabilité et l’accessibilité des technologies d’IA pour les entreprises et les développeurs.
Des solutions innovantes, comme l’optimisation du traitement des tokens ou l’intégration de mécanismes d’apprentissage plus efficaces, sont à l’étude pour réduire l’empreinte carbone des modèles d’IA. Ces avancées pourraient permettre une démocratisation plus large des technologies d’intelligence artificielle, en les rendant plus abordables et plus respectueuses de l’environnement.
Comment les tokens influencent-ils le traitement des données par les modèles d’IA ?
Les tokens segmentent les données en unités plus petites et gérables, permettant aux modèles d’analyser et de générer du contenu de manière plus efficace et précise.
Pourquoi le coût de traitement des tokens varie-t-il ?
Le coût dépend du type de token utilisé. Les tokens de sortie, qui nécessitent un traitement séquentiel, sont plus coûteux que ceux d’entrée, traités en parallèle.
Quels sont les avantages des modèles multimodaux en termes de tokenisation ?
Les modèles multimodaux peuvent traiter différents types de données, comme le texte, l’image et l’audio, en utilisant des tokens adaptés à chaque format, ce qui élargit les capacités des systèmes d’IA.
Comment la tokenisation évolue-t-elle avec les nouvelles technologies d’IA ?
La tokenisation évolue pour s’adapter aux nouvelles exigences des modèles d’IA, en intégrant des stratégies plus dynamiques pour optimiser le traitement des différentes langues et formats de données.